Context Engineering:管理LLM的“内存”
从上下文的组成、常见问题与管理方法出发,整理对 Context Engineering 的个人理解。
这个主题有很多文章和视频都讲过,也讲的很好,所以,今天这篇 blog 只是阐述自己的理解。
1. 概念(What)#
1.1 什么是 Context Engineering#
Context Engineering 指的是将上下文窗口当成稀缺的计算机资源,在下一步操作中,为模型的上下文窗口填充恰到好处的信息。
引用 Karpathy 的观点:
LLM as a new OS. Context is RAM
Karpathy 说的都这么牛逼了,那么上下文工程的重要性不言而喻(bush
1.2 组成部分#
那么这么牛逼的上下文工程包含哪几个部分呢?
分为三类看:
- Instructions
- System Prompt:模型整体行为的初始指令,包含示例、规则等。
- Structured Output:模型输出的格式,例如 JSON 格式的对象。
- User Prompt:用户提出的即时任务或问题。
- Knowledge
- Long-Term Memory:跨多次对话积累的持久性记忆,比如用户喜好、历史项目摘要、记住的特定事实等。这个部分值得仔细学习。
- Short-Term Memory:用户和模型此前的对话内容,展现当前交流的背景。
- RAG:外部的、最新(对模型而言)的信息,包括从文档、数据库或 API 获取的相关内容。
- Tools:模型可以调用的所有函数或内置工具定义(如 bash、发送邮件等)。
可以看出那时候已经有 Harness 的影子了,或者说 Harness 一直存在,只是这些东西以一个叫 Harness 的名字总结出来了。
2. 为什么需要 Context Engineering(Why)#
关键点:只要是出现在模型上下文窗口中的内容,模型必须关注它。
2.1 信息的角度#
举个不太恰当的例子,如果你在 24-25 那段时间使用过 ChatGPT、DeepSeek 这些聊天产品时,每次聊天你都需要写大量的 Prompt,把前因后果重新交代一遍。那时候 Prompt Engineering 这个概念和岗位也是盛极一时。
比如,我现在正在某个公司实习,压力好大,公司是要完蛋了嘛,实习生压力这么大嘛,嗯,我想跳槽了,想问问你有没有什么建议。
那么这里你又可能需要贴上公司的信息、你个人的一些信息等等。
如果是现在的 ChatGPT,那么就可以将你之前的聊天内容沉淀为一份用户画像,以及之前你们聊过的一些信息也可以翻阅到(memory)。嗯,好处多多的。
2.2 上下文干扰:Smart zone 和 Dumb zone#
当上下文变得过长时,模型过度关注上下文,而忽略了它在训练期间学到的内容。
在上下文还较小时,模型会很聪明(smart zone),但是,当超过某个阈值后(大约 150K tok),就会出现性能下降(dumb zone),token 消耗激增。
2.3 上下文污染#
当幻觉或其他错误进入上下文后,被反复引用,错误被不断沿用甚至放大的情况。
举个栗子,比如,模型在阅读代码时第一次就判断错了某个 API 的用途,之后所有基于此的分析都会在错误前提下展开,除非有人明确纠正;更危险的是,如果后续对话被压缩成摘要,这个错误结论很可能作为“已确认的事实”被保留下来,从此固化在上下文里。
又比如,你在一次与 Codex 的交流中,同意了一个错误的决策,那么这个错误可能会一直沿用下去,甚至放大。
2.4 上下文混淆#
上下文混淆是指模型利用上下文中多余的内容来生成低质量回答的现象。
在一段时间里,所有人都准备推出一个 MCP ↗。一个强大模型连接所有你的服务和各种东西、替你完成所有琐碎任务的梦想似乎触手可及。只需把所有工具描述扔进 system prompt,然后按下开始就行。在那时候,Claude ↗ 就是这么做的,因为它大部分内容都是工具定义或使用工具的说明。
- 工具描述过长、工具数量过多,本身就会造成上下文混淆。
2.5 上下文冲突#
在上下文中积累的新信息和工具,与上下文中的其他信息产生矛盾的情况。
微软和 Salesforce 团队在一篇论文 ↗中记录了一点——错误的上下文直接与提示中的其他信息相冲突。
LLM 们经常在早期阶段做出假设,并过早地尝试得出最终解决方案,而他们过度依赖这些解决方案。简而言之,我们发现,当 LLM 们在对话中走错方向时,他们会迷失方向,无法恢复。
可以看出,上述四个概念不是封闭隔离的,而是交叉在一起的。
“你中有我,我中有你,天下事坏就坏在这里”有人懂这个梗吗
3. 如何缓解和避免上下文出现问题呢(How)#
LangChain 的博客提出了四类上下文管理法:
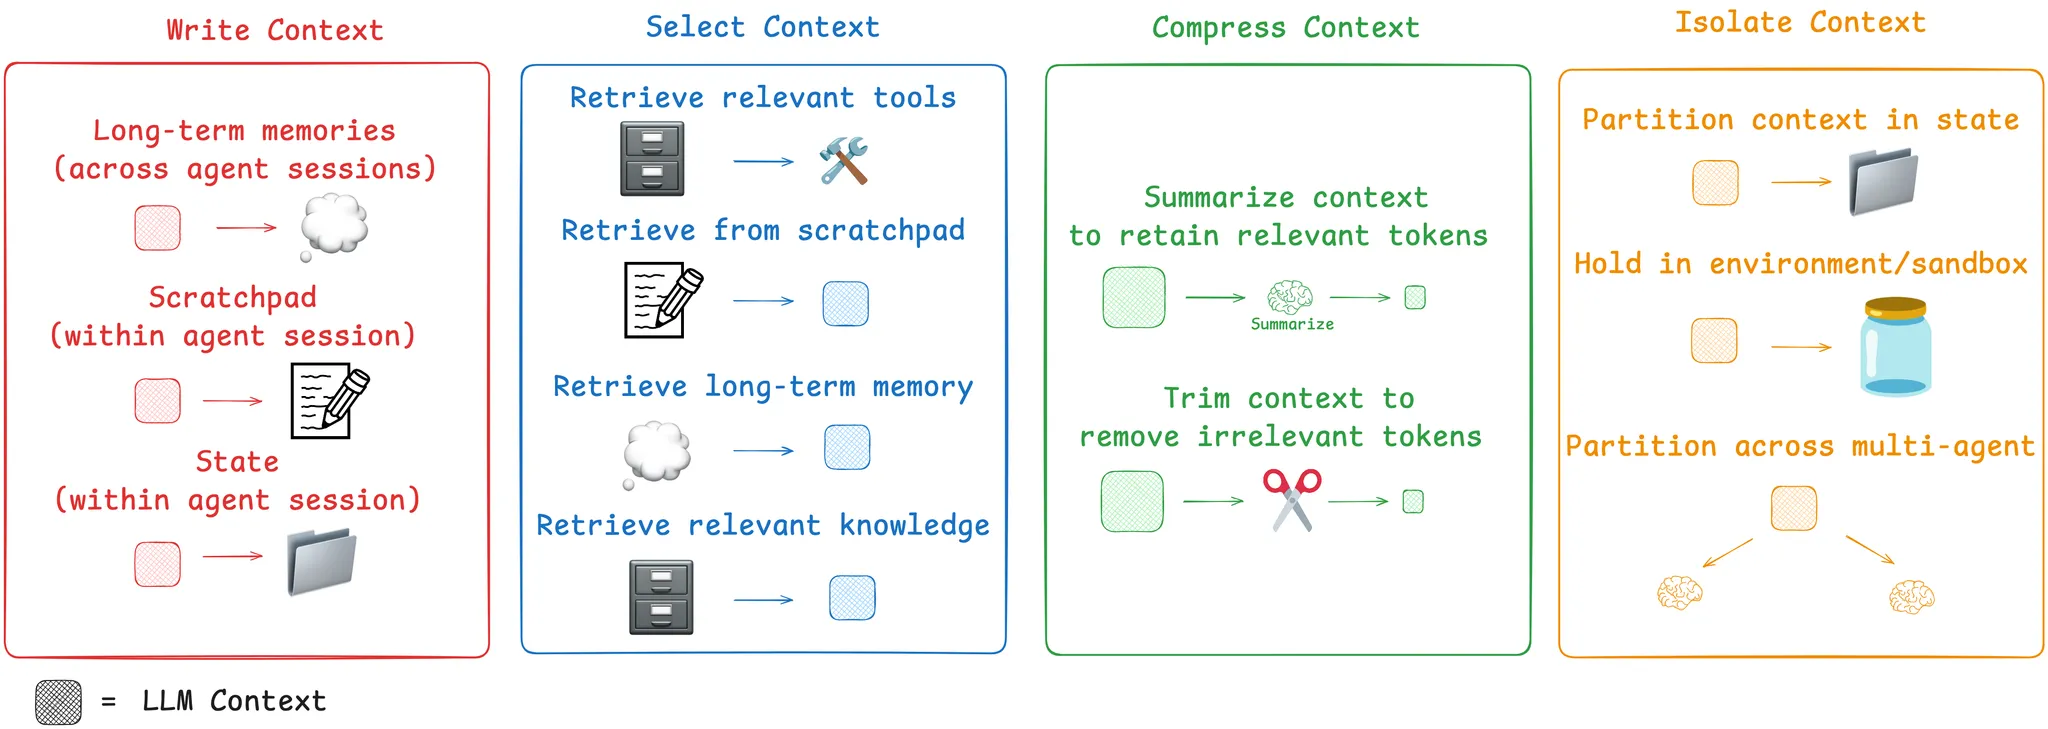
3.1 写入上下文#
将一些内容保留在上下文窗口之外。关键点在于如何组织好外部的上下文。
- AGENTS.md/CLAUDE.md:项目级别文档。
- Skill:分享自己的 SOP(比如 matt skills)。
- Memory:记忆系统,维护跨会话的记忆和短期会话记忆。
- Code repo:代码库本身是最可靠的上下文来源——真实代码与模型想象的差异,往往能直接暴露问题(这方面我也还在摸索)。
3.2 选择上下文#
将之前外部存储的记忆,以及其余的信息拉入上下文窗口。关键点在于如何召回到正确的信息,并且组织好上下文。
- 分层加载 AGENTS.md(OpenAI 实践):在每个项目文件夹下写入 AGENTS.md,帮助模型快速定位文件。
- 按需加载 Skill:在构建上下文时,仅加载 skill 的 name、description。
- RAG:检索增强生成。
- 代码索引:比如 DeepWiki。
- Tool loadout:将常用工具加载入上下文中,不常用的则在后续用得多了再加载到后续上下文中,还有 Tool search tool(缓加,慢加,有节奏地加,不紧不慢地加)。
写文章怎么这么累
3.3 压缩上下文#
简单来说就是对旧上下文进行压缩,以保留执行任务所需的 token。
- 滑动窗口:经典永不过时,丢弃旧消息,除了会丢失早期上下文没有缺点(hh)。
- LLM 摘要:调用 LLM 来对上下文进行摘要总结,丢细节保决策,夯。
- 工具结果替换:把 compact 当成固定流程,每轮对 tool_result 进行替换,在上下文快超阈值时自动触发。
- 剪枝算法:采用剪枝算法对上下文进行修剪、过滤。
3.4 隔离上下文#
简单来说,就是将模型的上下文拆出去,以达到缩小上下文管理压力的目的。
- multi agent:最流行的用法,将任务拆分给多个 sub agent,每个 sub agent 都有特定的工具、指令和上下文,但是 token 消耗也会激增。
- 环境隔离上下文:agent 生成代码并在沙箱环境中直接运行。工具调用的产物以变量形式存留于沙箱内,仅将真正需要的返回值或精炼结果传递回大模型。
- ……
4. 总结#
内存不够就压缩,内存太乱就选择,内存放不下就写进外部存储,多个进程抢内存就隔离——哦对,还要小心别往内存里倒垃圾(那是污染)。
所谓,Context Engineering 本质就是让模型在正确的时间,以正确的形式,获得完成当前步骤所必需的信息。
延伸阅读/参考文献#
- LangChain — Context Engineering ↗ — 面向 Agent 的上下文工程实践,系统总结写入、选择、压缩与隔离四类上下文管理方法
- Anthropic — Effective context engineering for AI agents ↗ — 从 Prompt Engineering 走向 Context Engineering,介绍上下文检索、压缩与长程任务管理
- 千问AI平台 — 浅谈上下文工程|从 Claude Code、Manus 和 Kiro 看提示工程到上下文工程的转变 ↗ — 结合 Claude Code、Manus 与 Kiro 的实践,梳理上下文工程的组成、价值与演进方向